
第 38 篇
工程技术
检索效果怎样评估,哪些指标容易误导
结合实际开发项目,讨论检索效果怎样评估,哪些指标容易误导,说明设计理由、关键源码、验证方法及适用边界。
本文目录 · 8 节
本文属于 Memory Center:AI 编程上下文与记忆系统工程实践,第 38 篇,位于“验证与完整实践”模块。案例背景统一采用实际开发项目;复现步骤使用脱敏教学样例,不代表特定生产事故。
从实际问题出发
增加返回数量可能提升命中概率,却同时增加无关上下文。调用次数减少也可能只是少查了关键消费者。因此检索质量需要一组明确任务和可核查的目标,而不是单一漂亮数字。
把离线命中与实际帮助分开
离线样例可检查期望来源是否进入结果,真实任务还要检查证据是否支持正确修改。延迟、成本、覆盖和负向断言错误都值得记录。小型 evaluate 实现只是起点,不代表已经具备充分规模的质量证明。
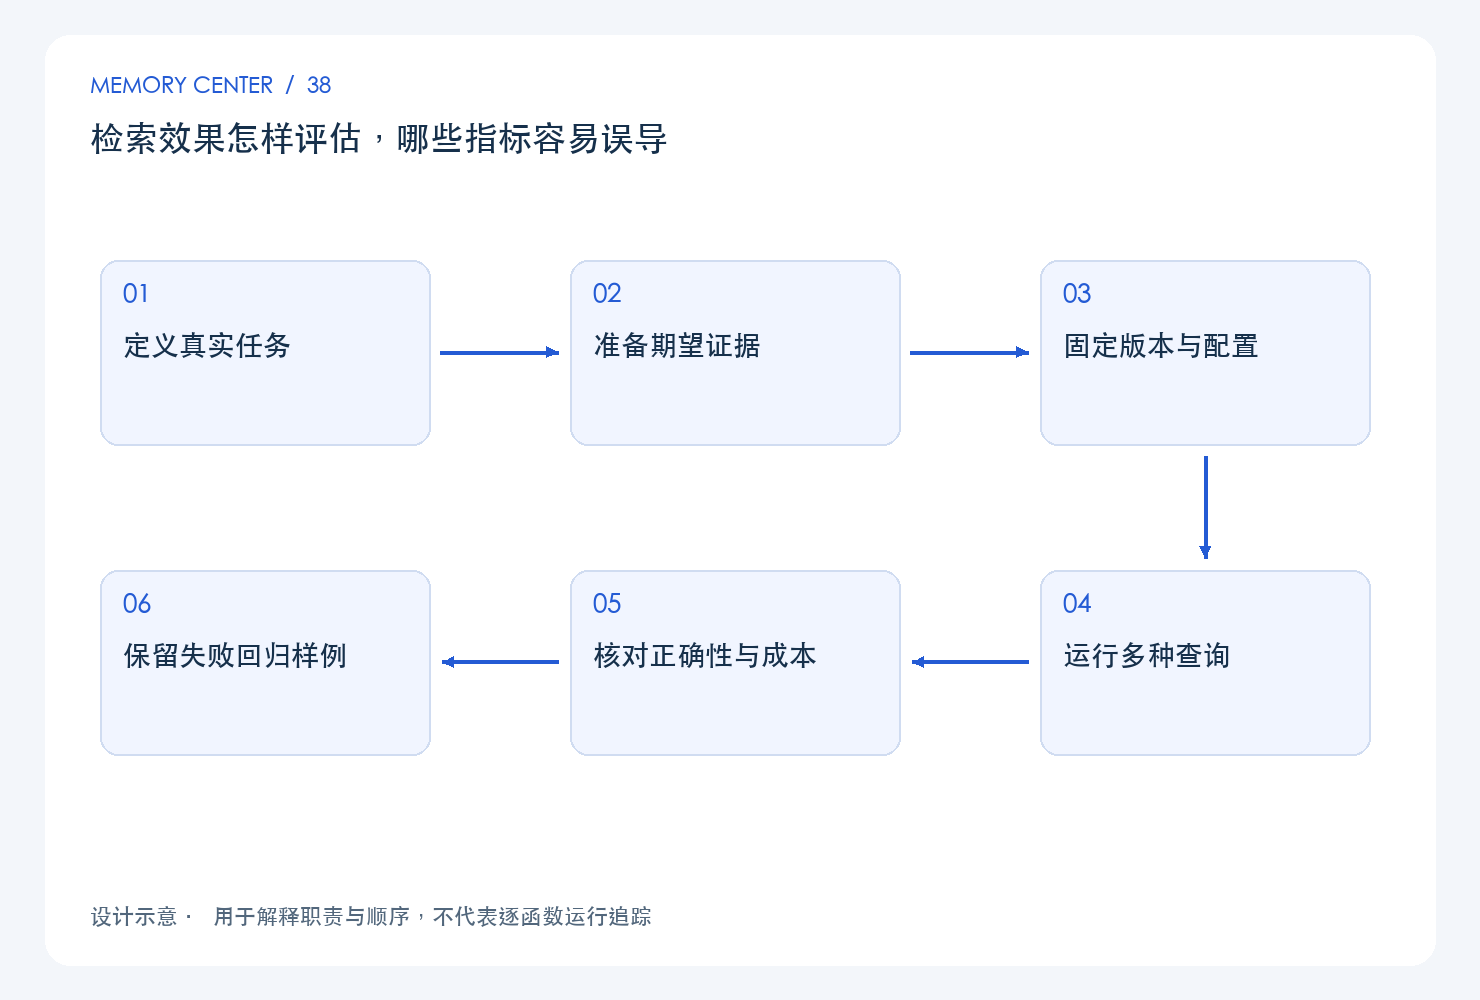
图中展示的是本篇关注的职责和顺序。正常流程之外,还要结合下面的源码与实验检查失败分支;它不是对某次线上调用的运行时追踪。
数据集也有生命周期
样例应脱敏,注明源码版本、查询、期望证据和判断依据。代码变化后旧标签可能失效,模型切换也需重测。失败样例应留在回归集中,不能只保留成功演示。
指标必须绑定定义
对人工给定的期望来源集合 E 和实际召回集合 R,可定义来源召回率 |E∩R|/|E|,来源精确率 |E∩R|/|R|。若 E 为空,不能直接套用除法;无结果场景需要独立定义正确拒答与错误否定的检查。
即使来源命中率很高,也不保证生成的修改正确。应继续区分证据是否被正确解释、测试是否发现行为变化,以及最终交付是否满足需求。来源指标是局部测量,不是 Agent 整体能力评分。
关键源码与阅读方法
源码基线为 Memory Center 6e90553(文档标注 5.0.0b24)。定位:memory_center/platform/evaluation.py,函数 evaluate,起始行 5。
以下为当前基线中的函数代码;依赖项目模块,不能作为独立脚本执行。
def evaluate(platform, actor, workspace_id, cases, limit=10):
    reports = []
    for case in cases:
        result = platform.lookup(actor, workspace_id, case['query'], case.get('mode', 'hybrid'), limit)
        found = {i['source'].get('source_id') or i['source'].get('path') for i in result.get('items', [])}
        found.discard(None)
        expected = set(case['expected_sources'])
        hits = len(expected & found)
        reports.append({'query_hash': hashlib.sha256(case['query'].encode()).hexdigest(),
            'expected_count': len(expected), 'retrieved_count': len(found), 'hits': hits,
            'recall': hits / len(expected), 'precision': hits / max(1, len(found)),
            'state': result['state'], 'reranking': result.get('reranking'),
            'vector_enabled': result.get('vector_enabled', False)})
    return {'cases': reports, 'mean_recall': sum(r['recall'] for r in reports) / len(reports),
            'mean_precision': sum(r['precision'] for r in reports) / len(reports),
            'answer_source': 'user_supplied', 'automatic_tuning': False}
阅读时先找输入由谁提供,再区分纯计算、读取和写入;遇到异常或提前返回,追问调用方会得到什么,以及已有状态是否仍然有效。上面的代码只证明展示范围内的实现,跨模块行为应继续查看调用处和相应测试。
用一个小实验核对设计
建议在独立临时目录和隔离数据中操作,使用虚构的接口、文档与项目名称。
- 创建精确标识、自然语言和无结果三类样例。
- 分别检查来源命中与错误断言。
- 记录实际延迟。
**要核对的结果:**本专题没有提供新的实测性能数字,读者应以自己的样例和环境复现后再作结论。
可把观察记录为下表;没有执行的项写“未执行”,不能用设计预期冒充实测结果。
| 核对项 | 应保留的证据 |
|---|---|
| 使用条件 | 源码版本、配置、输入与项目范围 |
| 正常行为 | 实际返回、来源位置或状态变化 |
| 关键失败分支 | 错误码、可见结果与原状态是否保留 |
| 结论范围 | 已覆盖、未覆盖和需要进一步验证的条件 |
适用边界与继续阅读
本篇以静态源码与项目设计为依据,给出可执行的核对方法,未据此宣称已经完成新的性能或生产环境测试。不同版本的入口、默认值和底层实现可能变化,应先核对当前合同,再把方法用于自己的实际开发项目。
理解这一节后,可以回到专题总导航,沿同一模块继续阅读;顺序学习时使用专栏内的上一篇和下一篇。涉及具体技术选择,应连同本篇的代价与限制一起采用。