
第 33 篇
工程技术
项目空间统计为什么不等于实际磁盘占用
结合实际开发项目,讨论项目空间统计为什么不等于实际磁盘占用,说明设计理由、关键源码、验证方法及适用边界。
本文目录 · 7 节
本文属于 Memory Center:AI 编程上下文与记忆系统工程实践,第 33 篇,位于“存储与运维治理”模块。案例背景统一采用实际开发项目;复现步骤使用脱敏教学样例,不代表特定生产事故。
从实际问题出发
管理页希望显示每个项目用了多少空间,但数据库页、WAL 和索引可能由多个项目共享。把文件逻辑长度和文本载荷相加后称为“实际磁盘占用”,会误导容量规划。
先定义统计口径
项目文件可按当前代际、历史代际和缓存分类,数据库可统计归属于项目的记录载荷。共享页与数据库管理开销另列说明,不做缺少依据的分摊。
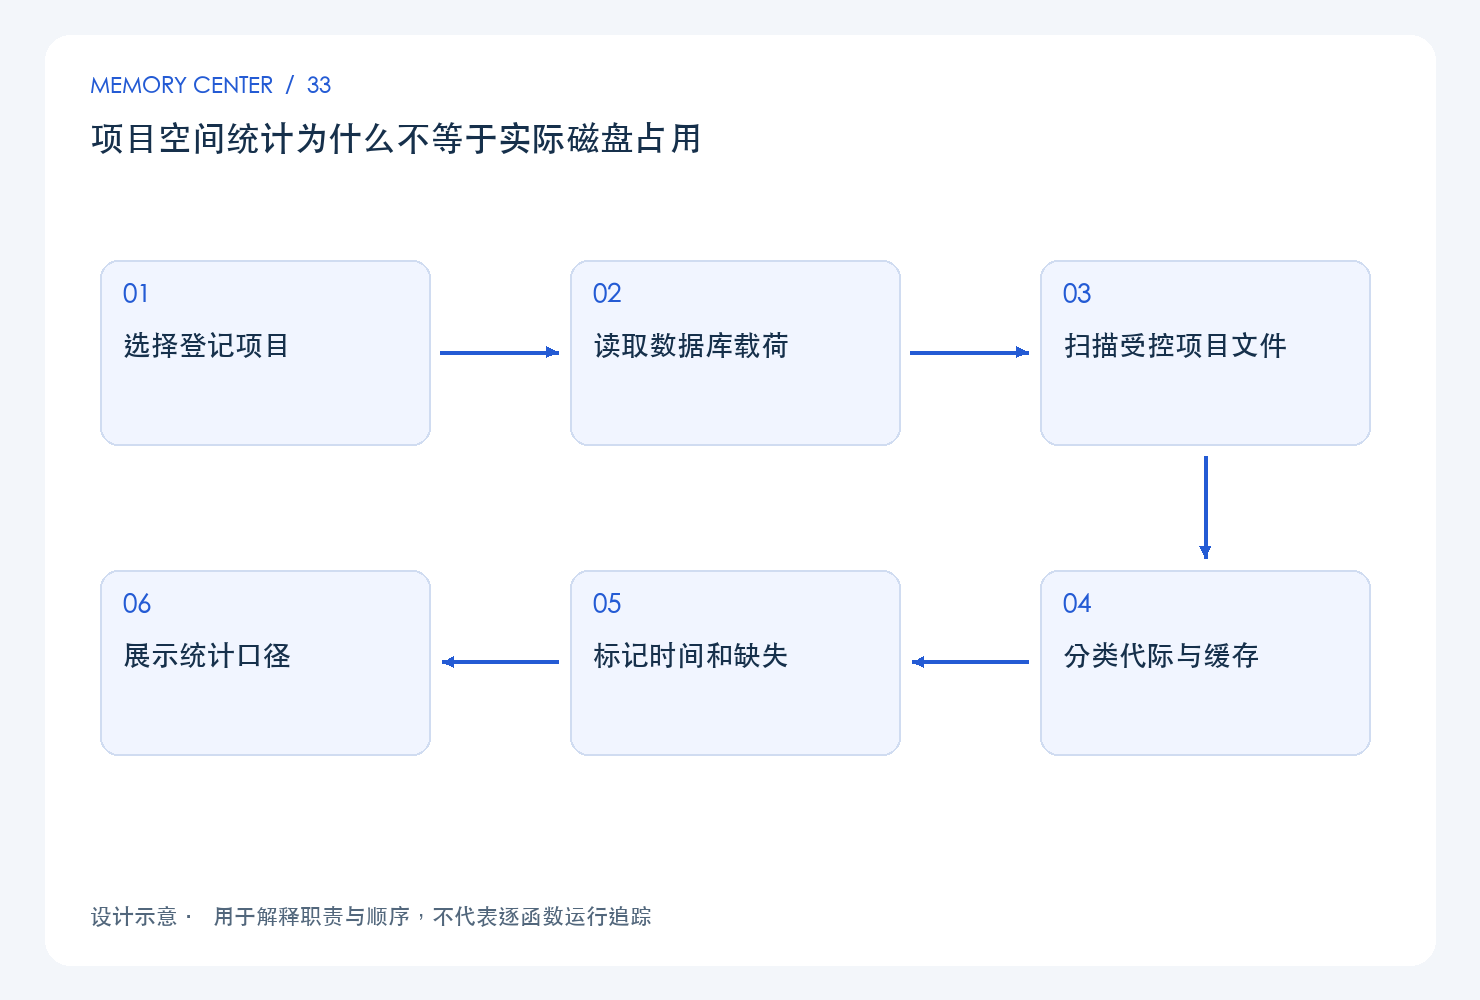
图中展示的是本篇关注的职责和顺序。正常流程之外,还要结合下面的源码与实验检查失败分支;它不是对某次线上调用的运行时追踪。
统计是有时间边界的观察
扫描期间索引可能变化,权限不足或符号链接会导致跳过。页面应展示统计时间与不完整标记,按需刷新,而不是在高频任务轮询中反复扫描全部目录。逻辑字节也不等于文件系统物理块占用。
关键源码与阅读方法
源码基线为 Memory Center 6e90553(文档标注 5.0.0b24)。定位:memory_center/platform/storage_usage.py,函数 workspace_storage,起始行 11。
以下为源码节选,省略后续分支;不能作为独立脚本执行。
def workspace_storage(store, workspace_id):
    if not re.fullmatch(r'ws_[a-f0-9]{32}', workspace_id):
        raise CatalogError('WORKSPACE_ID_INVALID', '项目 ID 无效')
    db = store.db
    length = (lambda column: f'octet_length({column})') if db.url else (lambda column: f'length(CAST({column} AS BLOB))')

    def text_size(columns):
        return '+'.join(f'COALESCE({length(column)},0)' for column in columns.split())

    with db.connection() as connection:
        if db.url:
            connection.execute('SET TRANSACTION ISOLATION LEVEL REPEATABLE READ READ ONLY')
        index = connection.execute("SELECT payload FROM records WHERE kind='index' AND id=?", (workspace_id,)).fetchone()
        generation = json.loads(index[0]).get('generation', '') if index else ''
        native = 'COALESCE(pg_column_size(vector_value),0)' if db.url else '0'
        chunks = connection.execute(f'''SELECT count(*) AS count,
            COALESCE(SUM({text_size('id workspace_id generation source_id content metadata profile embedding')}),0) AS text_bytes,
            COALESCE(SUM({native}),0) AS native_vector_bytes,
            COALESCE(SUM(CASE WHEN profile!='' AND embedding!='[]' THEN 1 ELSE 0 END),0) AS vector_count,
            COALESCE(SUM(CASE WHEN profile!='' AND embedding!='[]' THEN {length('embedding')} ELSE 0 END),0) AS vector_json_bytes
            FROM chunks WHERE workspace_id=?''', (workspace_id,)).fetchone()
        terms = connection.execute(f'''SELECT count(*) AS count,
            COALESCE(SUM({text_size('chunk_id workspace_id generation term')}),0) AS text_bytes
            FROM chunk_terms WHERE workspace_id=?''', (workspace_id,)).fetchone()
        records = connection.execute(f'''SELECT kind,count(*) AS count,
            COALESCE(SUM({text_size('id kind workspace_id owner payload updated_at')}),0) AS text_bytes
            FROM records WHERE workspace_id=? GROUP BY kind ORDER BY kind''', (workspace_id,)).fetchall()
    database = {'chunks': {key: int(chunks[key]) for key in chunks.keys()},
                'terms': {key: int(terms[key]) for key in terms.keys()},
                'records': [{'kind': row['kind'], 'count': int(row['count']), 'text_bytes': int(row['text_bytes'])} for row in records]}
    database['payload_bytes'] = int(chunks['text_bytes'] + chunks['native_vector_bytes'] + terms['text_bytes'] + sum(row['text_bytes'] for row in records))
    files = {key: 0 for key in ('current_generation_bytes', 'other_generations_bytes', 'parse_cache_bytes', 'embedding_cache_bytes', 'other_bytes', 'file_count', 'skipped_symlinks', 'read_errors')}
    base = db.data_dir / 'workspaces'
    root = base / workspace_id
    # 不跟随来源目录或项目存储目录中的符号链接。
    if base.is_symlink() or root.is_symlink():
阅读时先找输入由谁提供,再区分纯计算、读取和写入;遇到异常或提前返回,追问调用方会得到什么,以及已有状态是否仍然有效。上面的代码只证明展示范围内的实现,跨模块行为应继续查看调用处和相应测试。
用一个小实验核对设计
建议在独立临时目录和隔离数据中操作,使用虚构的接口、文档与项目名称。
- 记录一个示例项目的统计。
- 新增缓存后刷新。
- 比较数据库文件大小与项目记录载荷。
**要核对的结果:**差异应由口径解释,不能把数据库共享开销简单归给当前选中项目。
可把观察记录为下表;没有执行的项写“未执行”,不能用设计预期冒充实测结果。
| 核对项 | 应保留的证据 |
|---|---|
| 使用条件 | 源码版本、配置、输入与项目范围 |
| 正常行为 | 实际返回、来源位置或状态变化 |
| 关键失败分支 | 错误码、可见结果与原状态是否保留 |
| 结论范围 | 已覆盖、未覆盖和需要进一步验证的条件 |
适用边界与继续阅读
本篇以静态源码与项目设计为依据,给出可执行的核对方法,未据此宣称已经完成新的性能或生产环境测试。不同版本的入口、默认值和底层实现可能变化,应先核对当前合同,再把方法用于自己的实际开发项目。
理解这一节后,可以回到专题总导航,沿同一模块继续阅读;顺序学习时使用专栏内的上一篇和下一篇。涉及具体技术选择,应连同本篇的代价与限制一起采用。