
第 22 篇
工程技术
项目记忆为什么不能只是追加一段文本
结合实际开发项目,讨论项目记忆为什么不能只是追加一段文本,说明设计理由、关键源码、验证方法及适用边界。
本文目录 · 7 节
本文属于 Memory Center:AI 编程上下文与记忆系统工程实践,第 22 篇,位于“任务记忆与长期知识”模块。案例背景统一采用实际开发项目;复现步骤使用脱敏教学样例,不代表特定生产事故。
从实际问题出发
“这个接口没有消费者”在某次任务中可能只是猜测。如果直接进入长期记忆,下一次检索又会把它当作既定事实,形成错误自我强化。存储记忆之前必须表达它的状态。
内容与确认分开
同样的文本可以是待确认推断,也可以是经人工确认的记录。状态不应只藏在自然语言里,后续读取需要明确知道哪些内容可以默认使用、哪些只能作为线索。
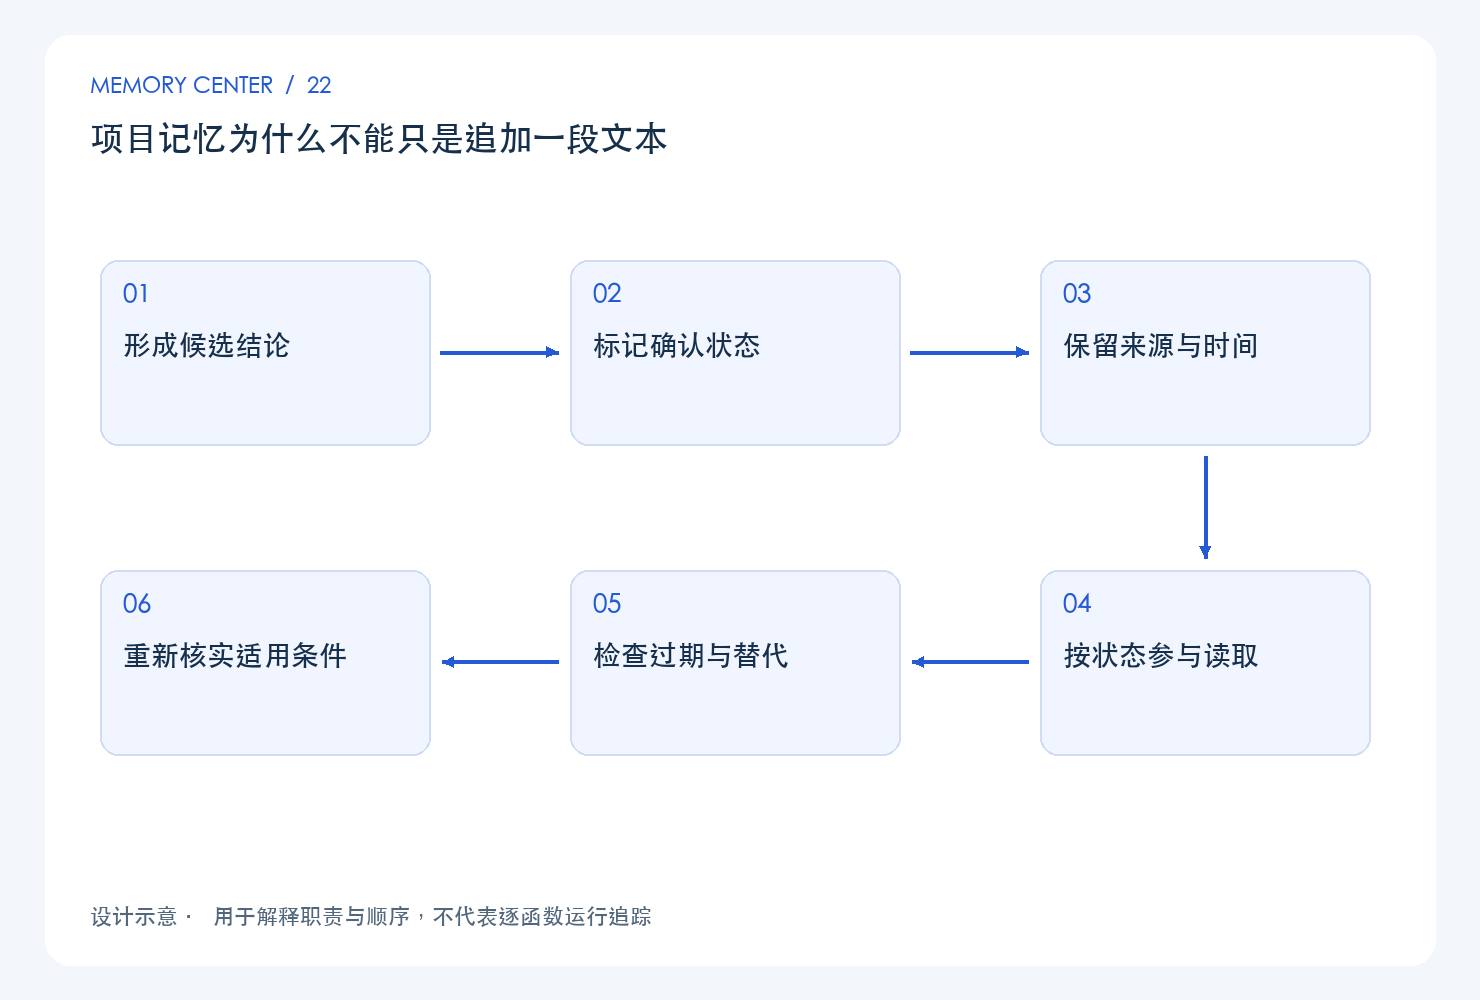
图中展示的是本篇关注的职责和顺序。正常流程之外,还要结合下面的源码与实验检查失败分支;它不是对某次线上调用的运行时追踪。
生命周期比新增按钮更重要
长期知识会过期,也可能被新记录替代。保留来源、时间和替代关系,才能解释为什么旧结论不再有效。确认只代表某种治理动作,不应被夸大为对所有未来代码状态的永久证明。
关键源码与阅读方法
源码基线为 Memory Center 6e90553(文档标注 5.0.0b24)。定位:memory_center/platform/knowledge.py,函数 memory,起始行 124。
以下为当前基线中的函数代码;依赖项目模块,不能作为独立脚本执行。
    def memory(self, actor, workspace_id, content, confirmed=False, replaces='', expires_at=''):
        if expires_at:
            try:
                timestamp = datetime.fromisoformat(expires_at)
                if timestamp.tzinfo is None:
                    raise ValueError()
            except ValueError:
                raise CatalogError('MEMORY_EXPIRY_INVALID', '过期时间需为包含时区的 ISO 时间') from None
        if replaces:
            previous = self.store.get('memory', replaces)
            if previous['workspace_id'] != workspace_id or previous['owner'] != actor:
                raise CatalogError('FORBIDDEN', '被替代记忆不属于当前主体')
        return self.store.create('memory', {'workspace_id': workspace_id, 'owner': actor, 'title': content[:80],
                          'content': content, 'status': 'confirmed' if confirmed else 'pending',
                          'replaces': replaces, 'expires_at': expires_at})
阅读时先找输入由谁提供,再区分纯计算、读取和写入;遇到异常或提前返回,追问调用方会得到什么,以及已有状态是否仍然有效。上面的代码只证明展示范围内的实现,跨模块行为应继续查看调用处和相应测试。
用一个小实验核对设计
建议在独立临时目录和隔离数据中操作,使用虚构的接口、文档与项目名称。
- 分别写入待确认与已确认的脱敏记忆。
- 查看检索可见性。
- 再更新相关源码并核对记忆适用条件。
**要核对的结果:**推断不能无标记地变成确定事实,历史记忆不能覆盖更新的源码证据。
可把观察记录为下表;没有执行的项写“未执行”,不能用设计预期冒充实测结果。
| 核对项 | 应保留的证据 |
|---|---|
| 使用条件 | 源码版本、配置、输入与项目范围 |
| 正常行为 | 实际返回、来源位置或状态变化 |
| 关键失败分支 | 错误码、可见结果与原状态是否保留 |
| 结论范围 | 已覆盖、未覆盖和需要进一步验证的条件 |
适用边界与继续阅读
本篇以静态源码与项目设计为依据,给出可执行的核对方法,未据此宣称已经完成新的性能或生产环境测试。不同版本的入口、默认值和底层实现可能变化,应先核对当前合同,再把方法用于自己的实际开发项目。
理解这一节后,可以回到专题总导航,沿同一模块继续阅读;顺序学习时使用专栏内的上一篇和下一篇。涉及具体技术选择,应连同本篇的代价与限制一起采用。