
第 19 篇
工程技术
混合检索:召回、RRF 与重排如何配合
结合实际开发项目,讨论混合检索:召回、RRF 与重排如何配合,说明设计理由、关键源码、验证方法及适用边界。
本文目录 · 8 节
本文属于 Memory Center:AI 编程上下文与记忆系统工程实践,第 19 篇,位于“检索与证据组合”模块。案例背景统一采用实际开发项目;复现步骤使用脱敏教学样例,不代表特定生产事故。
从实际问题出发
“连接池耗尽怎么处理”可能命中说明文档,“pool.max-size”则更像精确配置搜索。关键词和向量擅长的查询不同,混合检索用于组合候选,而不是证明某一种算法全面替代另一种。
融合前先理解分数
关键词得分与向量距离不在同一个量纲,直接相加需要谨慎校准。RRF 按各列表的排名融合,降低对原始分数尺度的依赖;后续可选重排再对候选与问题的相关性进行判断。
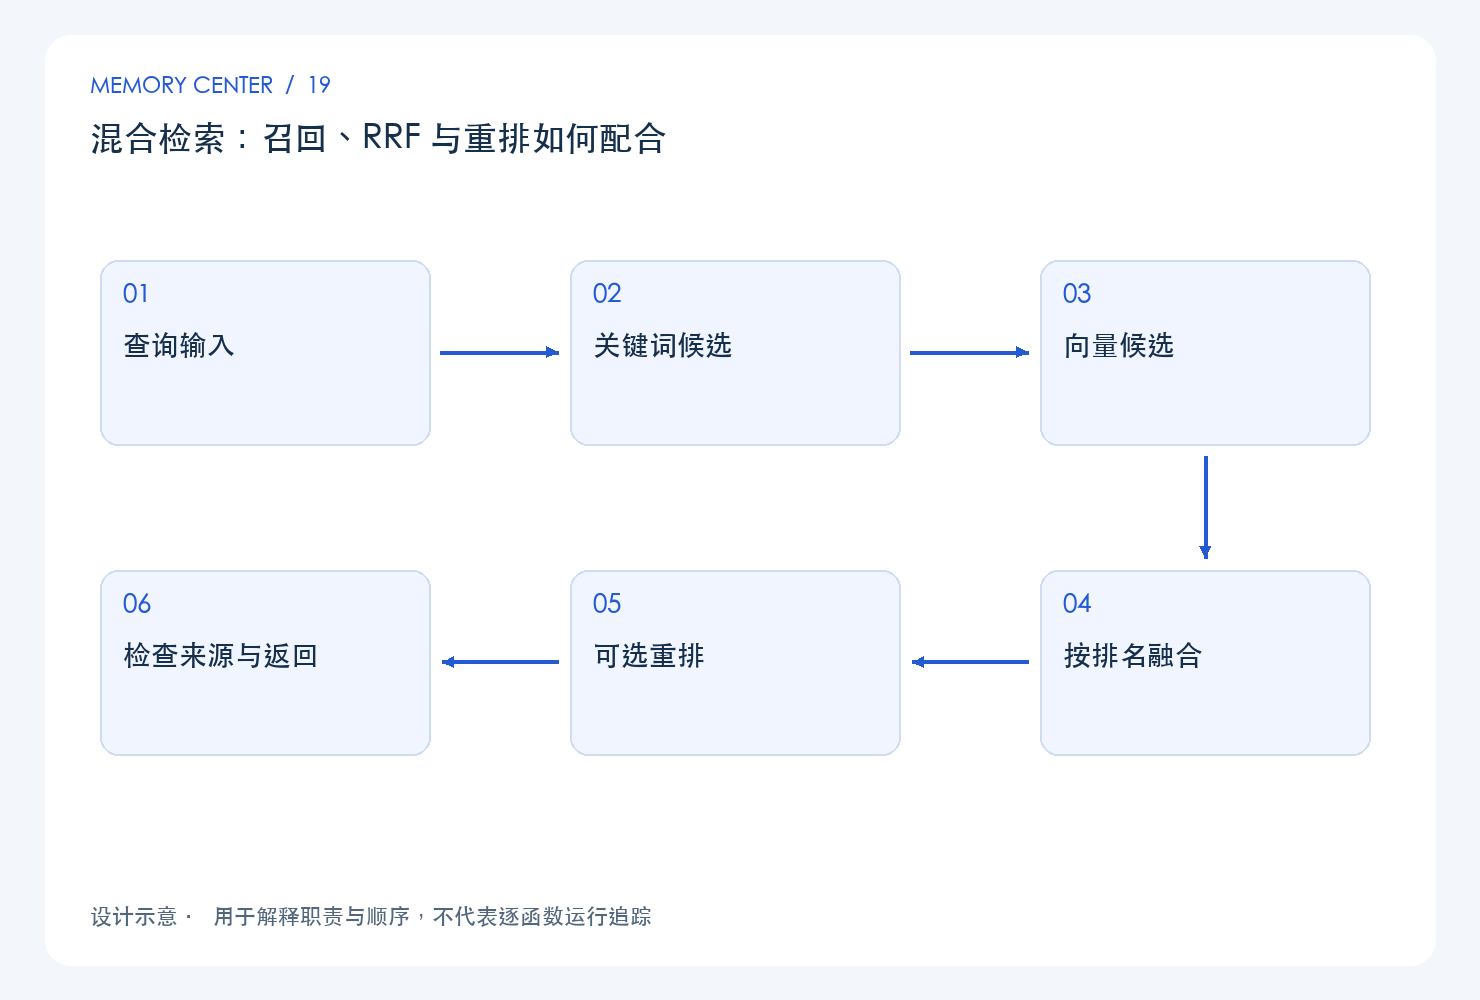
图中展示的是本篇关注的职责和顺序。正常流程之外,还要结合下面的源码与实验检查失败分支;它不是对某次线上调用的运行时追踪。
每个阶段有独立成本
向量生成、数据库召回与重排都可能失败或变慢。关闭向量时需要明确降级,模型档案过期时需要说明状态。无论排名多靠前,语义相似都不能证明两个方法存在调用关系。
RRF 的一个可手算例子
当前融合代码采用 1 / (60 + rank) 的贡献,排名从 1 开始。若候选甲在关键词列表排第 1、向量列表排第 3,它获得 1/61 + 1/63;候选乙只在一个列表排第 1,则只有 1/61。
这个规则会奖励多路共同支持的候选,但并不证明甲一定更正确。语料重复、权限过滤位置、候选上限和重排模型都会影响最终结果。实际评估应包含“精确标识只被关键词找到”等反例。
关键源码与阅读方法
源码基线为 Memory Center 6e90553(文档标注 5.0.0b24)。定位:memory_center/platform/retrieval.py,函数 search,起始行 54。
以下为源码节选,省略后续分支;不能作为独立脚本执行。
        fused, rows = collections.defaultdict(float), {}
        for ranked in [keyword_rows, vector_rows]:
            for position, row in enumerate(ranked):
                fused[row['id']] += 1 / (60 + position + 1)
                rows[row['id']] = row
        items = []
        for chunk_id in sorted(rows, key=lambda key: (-fused[key], key))[:min(100, max(limit, limit * 3))]:
            row = rows[chunk_id]
            items.append({'chunk_id': chunk_id, 'content': row['content'][:6000],
                          'source': json.loads(row['metadata']), 'score': round(fused[chunk_id], 6),
                          'generation': generation, 'workspace_id': workspace_id})
        rerank_settings = self.store.list('rerank_model', limit=1)
        items, reranking = Reranker(rerank_settings[0] if rerank_settings else {}).rank(query, items)
        return {'state': 'FOUND' if items else 'NOT_FOUND', 'items': items[:limit], 'reranking': reranking,
                'vector_enabled': vector_enabled and not profile_stale, 'vector_reindex_required': profile_stale,
                'embedding_mode': embedding_mode, 'generation': generation, 'negative_claim_allowed': False}
阅读时先找输入由谁提供,再区分纯计算、读取和写入;遇到异常或提前返回,追问调用方会得到什么,以及已有状态是否仍然有效。上面的代码只证明展示范围内的实现,跨模块行为应继续查看调用处和相应测试。
用一个小实验核对设计
建议在独立临时目录和隔离数据中操作,使用虚构的接口、文档与项目名称。
- 准备精确配置键和自然语言问题两组样例。
- 分别查询 keyword、vector 和 hybrid。
- 记录来源与排序变化。
**要核对的结果:**比较真实命中和延迟;不能仅凭混合结果更多就认定质量更好。
可把观察记录为下表;没有执行的项写“未执行”,不能用设计预期冒充实测结果。
| 核对项 | 应保留的证据 |
|---|---|
| 使用条件 | 源码版本、配置、输入与项目范围 |
| 正常行为 | 实际返回、来源位置或状态变化 |
| 关键失败分支 | 错误码、可见结果与原状态是否保留 |
| 结论范围 | 已覆盖、未覆盖和需要进一步验证的条件 |
适用边界与继续阅读
本篇以静态源码与项目设计为依据,给出可执行的核对方法,未据此宣称已经完成新的性能或生产环境测试。不同版本的入口、默认值和底层实现可能变化,应先核对当前合同,再把方法用于自己的实际开发项目。
理解这一节后,可以回到专题总导航,沿同一模块继续阅读;顺序学习时使用专栏内的上一篇和下一篇。涉及具体技术选择,应连同本篇的代价与限制一起采用。