
第 13 篇
工程技术
如何用节点和边表达类、方法、接口与服务
结合实际开发项目,讨论如何用节点和边表达类、方法、接口与服务,说明设计理由、关键源码、验证方法及适用边界。
本文目录 · 7 节
本文属于 Memory Center:AI 编程上下文与记忆系统工程实践,第 13 篇,位于“索引与代码事实”模块。案例背景统一采用实际开发项目;复现步骤使用脱敏教学样例,不代表特定生产事故。
从实际问题出发
搜索某个方法只能找到出现位置,而维护者常问“谁调用它”“它暴露哪个接口”。节点和边把这些关系显式表达出来,使查询可以沿已知结构展开。
关系模型服务于问题
文件声明类、类声明方法、方法调用方法,属于不同边。不能把导入关系当作运行调用,也不能把共同标签当作依赖。稳定符号身份和可读名称要分开,避免同名方法被错误合并。
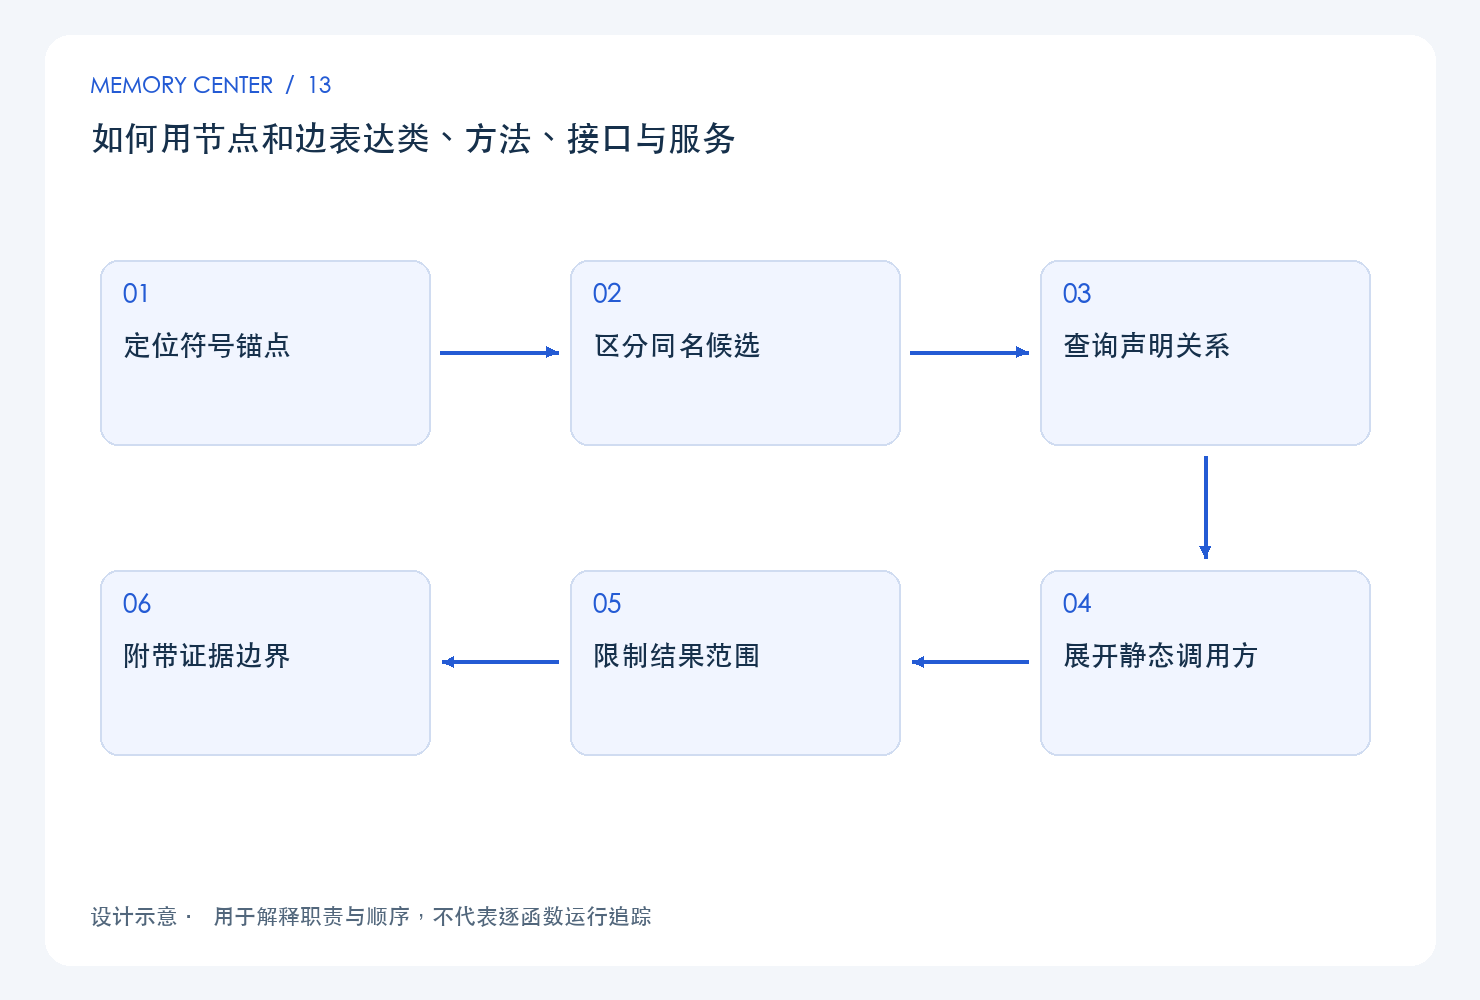
图中展示的是本篇关注的职责和顺序。正常流程之外,还要结合下面的源码与实验检查失败分支;它不是对某次线上调用的运行时追踪。
控制展开范围
调用图容易迅速膨胀。查询应限制候选、跳数和输出规模,并保留截断标记。空的调用方集合可能只是图没有覆盖动态行为,不能直接用于证明方法未使用。
关键源码与阅读方法
源码基线为 Memory Center 6e90553(文档标注 5.0.0b24)。定位:memory_center/platform/code_graph.py,函数 query_code_graph,起始行 341。
以下为源码节选,省略后续分支;不能作为独立脚本执行。
def query_code_graph(workspace_file, query, mode, limit=10):
    path = Path(workspace_file).parent / 'code-graph.json'
    if not path.is_file():
        return None  # 旧 generation 仅复用 Java 事实入口,需重新索引启用新图。
    graph = json.loads(path.read_text(encoding='utf-8'))
    symbols = graph['symbols']
    matches = [s for s in symbols if query in {s['id'], s['name'], s['qualified_name'], s['path'] + ':' + s['qualified_name']}]
    if not matches and mode == 'symbol':
        matches = [s for s in symbols if query.lower() in s['qualified_name'].lower()]
    # 锚点缺失时只能主张“符号不存在”,不受未解析调用影响,但仍要求覆盖完整。
    allowed, reason = claim_boundary(graph, (), require_no_unresolved=False)
    result = {'state': 'FOUND' if matches else 'NOT_FOUND', 'symbols': matches[:limit],
              'negative_claim_allowed': False, 'negative_claim_reason': '',
              'truncated': len(matches) > limit, 'coverage': coverage_summary(graph)}
    if mode == 'symbol':
        result['negative_claim_allowed'] = (not matches) and allowed
        result['negative_claim_reason'] = '' if matches else reason
        return result
    if len(matches) != 1:
        result['state'] = 'AMBIGUOUS' if matches else 'NOT_FOUND'
        result['chain'] = []
        result['message'] = '请使用 path:qualified_name 或 symbol id 精确定位' if matches else '当前范围未找到锚点'
        result['negative_claim_allowed'] = (not matches) and allowed
        result['negative_claim_reason'] = '' if matches else reason
        return result
    anchor = matches[0]
    result['anchor'] = anchor
    by_id = {s['id']: s for s in symbols}
    upstream = mode in {'callers', 'analyze'}
    anchor_ids = {anchor['id']}
    if anchor['type'] == 'Class':
        anchor_ids.update(s['id'] for s in symbols if s['path'] == anchor['path'] and
                          s['type'] == 'Function' and s['parent'] == anchor['qualified_name'])
    links = [e for e in graph['edges'] if e['target' if upstream else 'source'] in anchor_ids]
    result['chain'] = [{'symbol': by_id[e['source' if upstream else 'target']], 'call': e} for e in links[:limit]]
    result['unresolved_calls'] = [u for u in graph['unresolved'] if u['path'] == anchor['path'] and
阅读时先找输入由谁提供,再区分纯计算、读取和写入;遇到异常或提前返回,追问调用方会得到什么,以及已有状态是否仍然有效。上面的代码只证明展示范围内的实现,跨模块行为应继续查看调用处和相应测试。
用一个小实验核对设计
建议在独立临时目录和隔离数据中操作,使用虚构的接口、文档与项目名称。
- 建立两个同名方法和一个明确接收者。
- 查询各自调用方。
- 用小 limit 检查截断表达。
**要核对的结果:**结果要区分歧义与唯一锚点,并能回到边的源码依据。
可把观察记录为下表;没有执行的项写“未执行”,不能用设计预期冒充实测结果。
| 核对项 | 应保留的证据 |
|---|---|
| 使用条件 | 源码版本、配置、输入与项目范围 |
| 正常行为 | 实际返回、来源位置或状态变化 |
| 关键失败分支 | 错误码、可见结果与原状态是否保留 |
| 结论范围 | 已覆盖、未覆盖和需要进一步验证的条件 |
适用边界与继续阅读
本篇以静态源码与项目设计为依据,给出可执行的核对方法,未据此宣称已经完成新的性能或生产环境测试。不同版本的入口、默认值和底层实现可能变化,应先核对当前合同,再把方法用于自己的实际开发项目。
理解这一节后,可以回到专题总导航,沿同一模块继续阅读;顺序学习时使用专栏内的上一篇和下一篇。涉及具体技术选择,应连同本篇的代价与限制一起采用。