
第 11 篇
工程技术
一份源码如何变成可查询的工程事实
结合实际开发项目,讨论一份源码如何变成可查询的工程事实,说明设计理由、关键源码、验证方法及适用边界。
本文目录 · 7 节
本文属于 Memory Center:AI 编程上下文与记忆系统工程实践,第 11 篇,位于“索引与代码事实”模块。案例背景统一采用实际开发项目;复现步骤使用脱敏教学样例,不代表特定生产事故。
从实际问题出发
AI 接口返回一条方法关系之前,系统已经完成目录识别、文件归属、语法解析和关系存储。把索引当成一个黑箱按钮,会让解析缺失和归属错误一直到查询阶段才暴露。
拆开索引阶段
源文件先归属项目与服务,再提取声明、导入和调用候选,最后解析可证明的目标。候选调用不等于已解析调用,统计时必须分列;否则符号很多也可能掩盖关系覆盖很差。
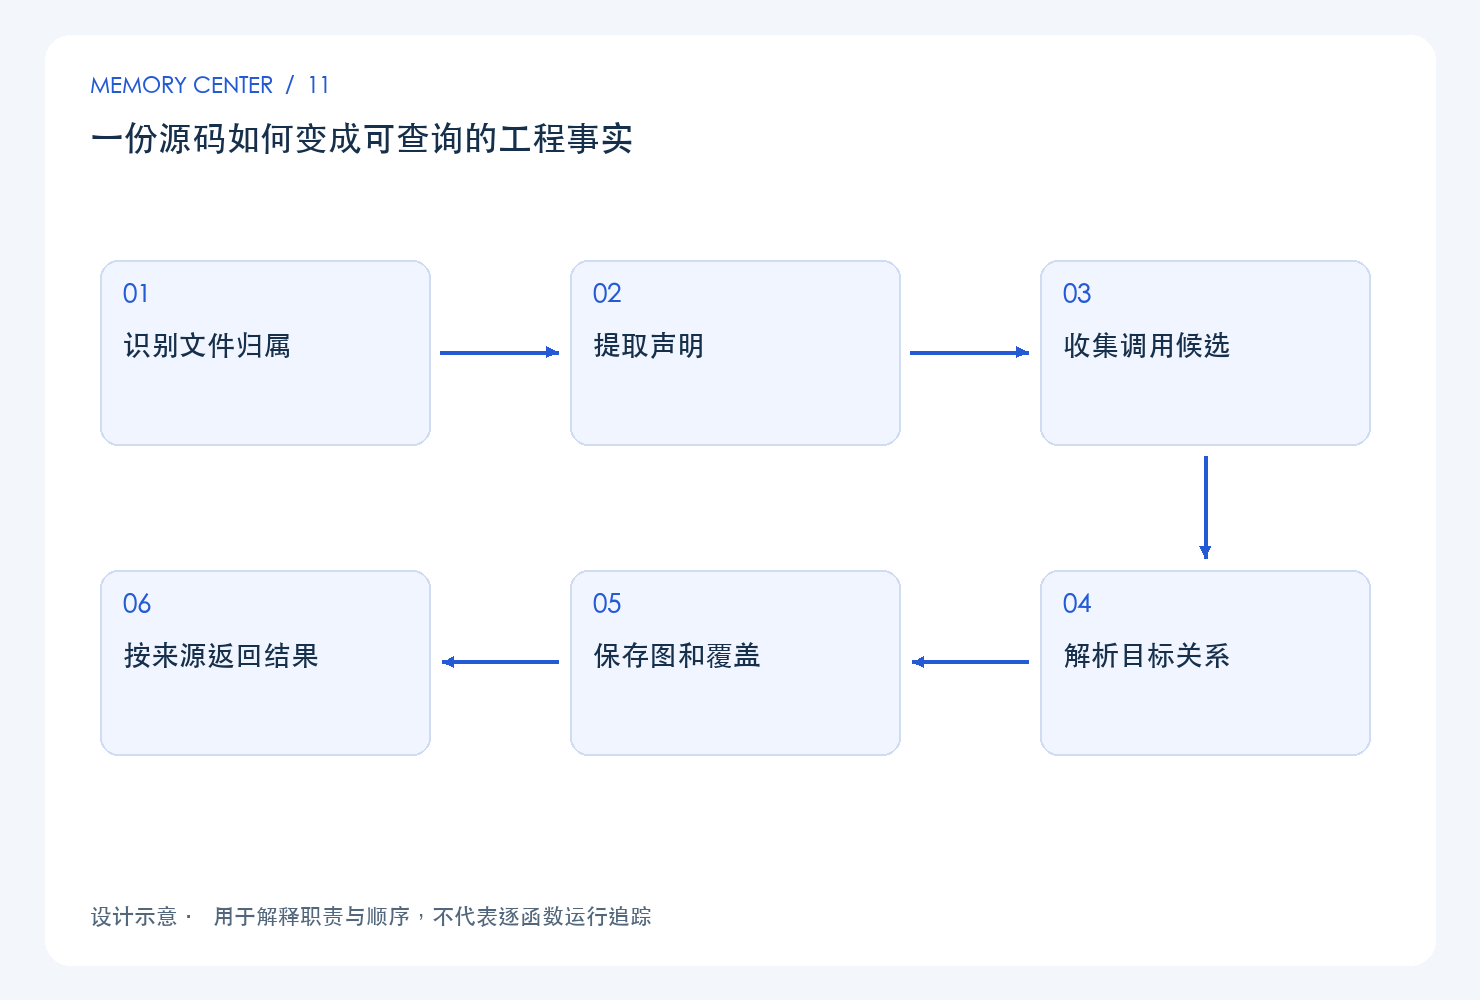
图中展示的是本篇关注的职责和顺序。正常流程之外,还要结合下面的源码与实验检查失败分支;它不是对某次线上调用的运行时追踪。
保留可核查来源
符号与关系应能回到文件和位置,查询还要检查当前源码是否与索引一致。代码图是源码的派生资产,可以重建,但不是运行时所有行为的完整记录。反射、动态路由和生成代码要明确标为静态能力边界。
关键源码与阅读方法
源码基线为 Memory Center 6e90553(文档标注 5.0.0b24)。定位:memory_center/platform/code_graph.py,函数 build_code_graph,起始行 73。
以下为源码节选,省略后续分支;不能作为独立脚本执行。
def build_code_graph(root, files, progress=None, pool=None, cache=None, digests=None):
    """构建通用代码图。

    ``pool`` 为 :class:`memory_center.platform.work_pool.WorkPool`;为 ``None``
    或宽度为 1 时就地串行。两条路径产出的 ``units``/``symbols``/``coverage``
    必须逐值相等——``WorkPool.map`` 保持输入顺序,故 ``units`` 的插入顺序也一致,
    下游关系解析的边顺序因此不变。

    ``cache`` 为 :class:`memory_center.platform.parse_cache.ParseCache`;只缓存
    文件级结构事实。跨文件关系(导入绑定落到哪个文件、调用边)留在下面的归并
    阶段每次重算,因此改动文件的影响不会被缓存掩盖。

    ``digests`` 为 ``{绝对路径字符串: 内容 sha256}``,由调用方在扫描/切块阶段
    顺带算好(那里本来就要读全文切块)。提供时解析侧不再重复读文件、不重复算哈希,
    缓存命中即完全不碰盘;缺失的路径回退为解析侧自行读取并计算。
    """
    units, symbols, coverage = {}, [], {}
    digests = digests or {}
    parse_files = [p for p in files if get_language_spec_for_extension(p.suffix) is not None]
    units_input = [(p.relative_to(root).as_posix(), str(p), digests.get(str(p), ''), cache) for p in parse_files]
    if pool is not None and pool.parallel:
        outcomes = pool.map(parse_file_unit, units_input)
    else:
        outcomes = [parse_file_unit(item) for item in units_input]
    for number, (relative, language, status, digest, result) in enumerate(outcomes, 1):
        coverage[relative] = {'language': language, 'status': status, 'hash': digest}
        if result is not None:
            units[relative] = result
            for kind, declarations in [('Class', result.classes), ('Function', result.functions)]:
                for declaration in declarations:
                    key = f'{relative}:{kind}:{declaration.qualified_name}:{declaration.line}'
                    symbols.append({'id': 'symbol_' + hashlib.sha256(key.encode()).hexdigest(), 'type': kind,
                                    'name': declaration.name, 'qualified_name': declaration.qualified_name,
                                    'parent': declaration.qualified_name.rpartition('.')[0] if result.language == 'go' and declaration.kind == 'method' else declaration.parent_qualified_name, 'path': relative,
                                    'line': declaration.line, 'end_line': declaration.end_line,
                                    'language': language, 'module': result.module or '', 'hash': digest})
阅读时先找输入由谁提供,再区分纯计算、读取和写入;遇到异常或提前返回,追问调用方会得到什么,以及已有状态是否仍然有效。上面的代码只证明展示范围内的实现,跨模块行为应继续查看调用处和相应测试。
用一个小实验核对设计
建议在独立临时目录和隔离数据中操作,使用虚构的接口、文档与项目名称。
- 创建声明、直接调用和动态调用三种示例。
- 索引后检查节点与关系。
- 修改文件并查询旧结果。
**要核对的结果:**直接关系应有来源,无法解析的调用应计入覆盖边界而非静默忽略。
可把观察记录为下表;没有执行的项写“未执行”,不能用设计预期冒充实测结果。
| 核对项 | 应保留的证据 |
|---|---|
| 使用条件 | 源码版本、配置、输入与项目范围 |
| 正常行为 | 实际返回、来源位置或状态变化 |
| 关键失败分支 | 错误码、可见结果与原状态是否保留 |
| 结论范围 | 已覆盖、未覆盖和需要进一步验证的条件 |
适用边界与继续阅读
本篇以静态源码与项目设计为依据,给出可执行的核对方法,未据此宣称已经完成新的性能或生产环境测试。不同版本的入口、默认值和底层实现可能变化,应先核对当前合同,再把方法用于自己的实际开发项目。
理解这一节后,可以回到专题总导航,沿同一模块继续阅读;顺序学习时使用专栏内的上一篇和下一篇。涉及具体技术选择,应连同本篇的代价与限制一起采用。